Domain ntkj.de kaufen?
Wir ziehen mit dem Projekt
ntkj.de um.
Sind Sie am Kauf der Domain
ntkj.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain ntkj.de kaufen?
Was bedeutet Hate Speech?
Hate Speech bezeichnet beleidigende, diskriminierende oder gewalttätige Äußerungen, die aufgrund von Rasse, Religion, Geschlecht, sexueller Orientierung oder anderen persönlichen Merkmalen Hass und Feindseligkeit fördern. Es handelt sich um eine Form der verbalen Gewalt, die Menschen verletzen und ihre Rechte verletzen kann. Hate Speech ist in vielen Ländern gesetzlich verboten und wird von Online-Plattformen und sozialen Medien zunehmend bekämpft. **
Was ist Hate Speech?
Hate Speech bezieht sich auf Äußerungen, die Hass, Diskriminierung oder Gewalt gegen bestimmte Personen oder Gruppen aufgrund ihrer Rasse, Religion, sexuellen Orientierung, Geschlecht oder anderer Merkmale fördern oder unterstützen. Diese Äußerungen können sowohl online als auch offline stattfinden und haben das Potenzial, Schaden anzurichten und die Opfer zu verletzen. Hate Speech wird oft als Verstoß gegen die Meinungsfreiheit betrachtet, aber es gibt rechtliche Grenzen, die den Schutz vor Hass und Diskriminierung gewährleisten sollen. **
Ähnliche Suchbegriffe für Speech-Acts-in-Securitization
Top-Angebote
Produkte zum Begriff Speech-Acts-in-Securitization:
-
Waves Dugan SpeechWaves Dugan Speech (ESD); Automix-Plugin; Automix-Anwendung für Waves SuperRack und eMotion LV1 Mixer, entwickelt in Zusammenarbeit mit Dan Dugan; mischt bis zu 64 Live-Mikrofonkanäle gleichzeitig automatisch und in Echtzeit; kein manuelles Regeln notwendig; sichert konstanten Gesamtpegel; perfekt abgestimmte Crossfades; nahtlose Integration in eMotion LV1 Mixer sowie SuperRack; unterstützte Formate: Waves SuperRack, eMotion LV1 Mixer589,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
the t.bone Speech 100 Mthe t.bone Speech 100 M, Steuerzentrale für digitales Konferenzsystem, 2 Gruppen für jeweils bis zu 16 Sprechstellen, Feedbackunterdrückung, USB Aufnahme und Playback (*.mp3, Datenträger bis 32 GB), 4 Diskussionsmodi (3, 6, 9 oder alle Mikrofone können gleichzeitig aktiviert werden), Abstimmungs-Modus, 2x Stereo Rec Out (Cinch), 1x Stereo Out für Soundsystem (Cinch), 1x Stereo In (Cinch), 1x Mic In (XLR mit Phantomspeisung), 1x LAN, Abmessungen: 19" / 2HE, 32cm Einbautiefe, Gewicht 5,5 kg; passendes Case: Art. 496024 (nicht im Lieferumfang enthalten); passender Booster für mehr als 16 Sprechstellen je Linie: Art. 498125 (nicht im Lieferumfang enthalten)469,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
the t.bone Speech 100 Cthe t.bone Speech 100 C, Chairman, Präsidentensprechstelle für digitales Konferenzsystem, Kondensatormikrofon, LCD-Display, Tasten für Abstimmung, eingebauter Lautsprecher mit Lautstärkeregelung, Kopfhöreranschluss, Prioritätssteuerung für Präsidentensprechstelle, 2x LAN (In/Link), Mikrofon-Schwanenhalslänge ca. 40 cm, 1x 2m Netzwerkkabel im Lieferumfang enthalten, Abmessungen: 169 x 46 x 175 mm (B x H x T), Gewicht 0,7 kg198,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
the t.bone Speech 100 Bthe t.bone Speech 100 B - Netzteilerweiterung (Booster) für die Sprechstellen 100 C und 100 D des digitalen Konferenzsystem Speech 100, ein 100 B versorgt bis zu 32 zusätzliche Sprechstellen (1x 100 M +1x 100 B = 2x16 + 2x16 =64); mit einem zweiten sind bis zu 72 Mikrofonstationen (max.) möglich (1x 100 M +1x 100 B +1x 100 B = 2x12 + 2x12 +2x12 =72); Leistungsaufnahme 72W; Abmessungen; 305x197x45mm; Gewicht: 2,45kg169,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Wie klingt die deutsche Meme-Stimme in der Text-to-Speech-Technologie?
Die deutsche Meme-Stimme in der Text-to-Speech-Technologie kann je nach Anbieter und Einstellungen variieren. Generell wird sie jedoch oft als roboterhaft und künstlich klingend beschrieben, mit einer betonten und leicht übertriebenen Aussprache. Manche Stimmen haben auch einen humorvollen oder ironischen Unterton, um den memeartigen Charakter zu verstärken. **
-
Was sind die beliebtesten Acts in einem Zirkus?
Die beliebtesten Acts in einem Zirkus sind normalerweise Akrobaten, Clowns und Tierdressuren. Diese Acts bieten eine Mischung aus Spannung, Unterhaltung und Humor für das Publikum. Jeder Zirkus hat jedoch seine eigenen einzigartigen Acts, die die Besucher anlocken. **
-
Wie funktioniert Speech to Text?
Speech to Text funktioniert, indem gesprochene Wörter mithilfe von Spracherkennungssoftware in Text umgewandelt werden. Dabei werden die Audiosignale des gesprochenen Textes analysiert und in Text umgewandelt. Die Software erkennt dabei Sprachmuster, Wörter und Sätze, um sie korrekt zu transkribieren. Dieser Prozess basiert auf komplexen Algorithmen und künstlicher Intelligenz, die kontinuierlich verbessert werden, um die Genauigkeit der Umwandlung zu erhöhen. Das Ergebnis ist ein geschriebener Text, der die gesprochene Sprache möglichst genau wiedergibt. **
-
Wie hat sich die Text-to-Speech-Technologie in den Bereichen der barrierefreien Kommunikation, der Unterhaltungsindustrie und der Bildung weiterentwickelt?
Die Text-to-Speech-Technologie hat sich in den Bereichen der barrierefreien Kommunikation weiterentwickelt, indem sie eine verbesserte Sprachqualität und natürlichere Betonung bietet, um Menschen mit Sehbehinderungen den Zugang zu gedruckten Materialien zu erleichtern. In der Unterhaltungsindustrie hat die Technologie dazu beigetragen, Hörbücher, Podcasts und Videospielen eine realistischere und immersivere Erfahrung zu bieten. Im Bildungsbereich ermöglicht die Text-to-Speech-Technologie eine individualisierte Lernumgebung, in der Schüler mit unterschiedlichen Lernstilen und Bedürfnissen unterstützt werden können. Darüber hinaus hat die Technologie die Möglichkeit eröffnet, Lehrmaterialien in verschiedenen Sprachen und Dialekten zugänglicher zu machen. **
Wie hat sich die Text-to-Speech-Technologie in den Bereichen der barrierefreien Kommunikation, der Unterhaltungsindustrie und der Bildung weiterentwickelt?
Die Text-to-Speech-Technologie hat sich in den Bereichen der barrierefreien Kommunikation weiterentwickelt, indem sie Menschen mit Sehbehinderungen ermöglicht, gedruckte Texte in gesprochene Sprache umzuwandeln. In der Unterhaltungsindustrie wird die Technologie verwendet, um Hörbücher, Podcasts und Videospielen eine zusätzliche Dimension hinzuzufügen. In der Bildung wird Text-to-Speech eingesetzt, um Schülern mit Lernschwierigkeiten oder Sprachbehinderungen zu helfen, Texte besser zu verstehen und zu verarbeiten. Durch ständige Verbesserungen in der Spracherkennung und -synthese wird die Text-to-Speech-Technologie immer präziser und natürlicher. **
Wann ist das Hate-Speech-Gesetz in Kraft getreten?
Das Hate-Speech-Gesetz in Deutschland, das offiziell als Netzwerkdurchsetzungsgesetz (NetzDG) bekannt ist, ist am 1. Oktober 2017 in Kraft getreten. Es verpflichtet soziale Netzwerke dazu, rechtswidrige Inhalte innerhalb einer bestimmten Frist zu löschen. **
Top-Angebote
Produkte zum Begriff Speech-Acts-in-Securitization:
-
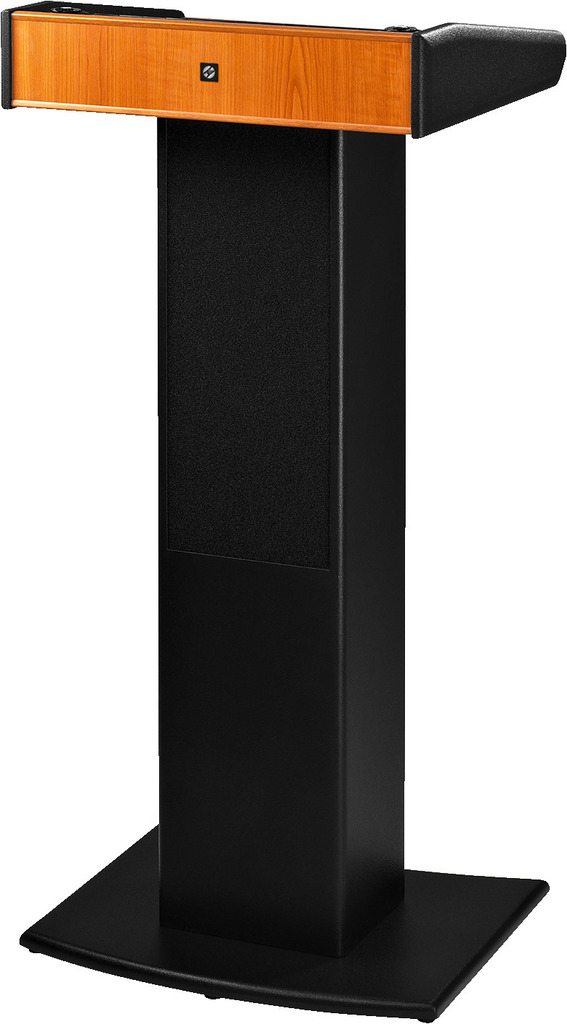
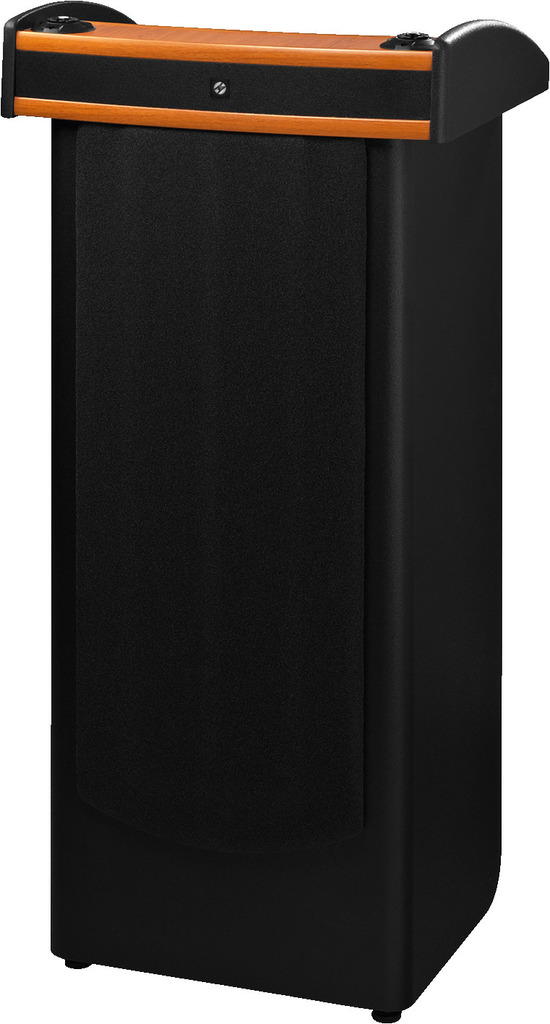
MONACOR SPEECH-104DSPEECH-104D, Eine innovative Qualit�tsl�sung f�r die hochwertige Sprach- und Musikbeschallung: Das SPEECH-104D-Aktiv-Rednerpult von MONACOR verbindet Klangqualit�t, Lautst�rkef�higkeit und Komfort in einer perfekten Weise. Akkubetrieben und damit komplett ortsunabh�ngig macht allein das SPEECH-104D aus jeder zu beschallenden Fl�che ein Auditorium. Es passt sich aber selbstverst�ndlich auch in jede gegebene Umgebung ein, wo eine zeitlich begrenzte oder auch permanente Redestelle ben�tigt wird. Die integrierte Verst�rker- und Lautsprechertechnik erlaubt dabei nicht nur die Sprachwiedergabe, sondern macht auch Musik und zum Beispiel Film- und Pr�sentationsvertonungen denkbar gut und einfach. Ein Schwanenhalsmikrofon einstecken und/oder eine Signalquelle anschlie�en - einschalten - fertig.1648,49 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Waves Dugan SpeechWaves Dugan Speech (ESD); Automix-Plugin; Automix-Anwendung für Waves SuperRack und eMotion LV1 Mixer, entwickelt in Zusammenarbeit mit Dan Dugan; mischt bis zu 64 Live-Mikrofonkanäle gleichzeitig automatisch und in Echtzeit; kein manuelles Regeln notwendig; sichert konstanten Gesamtpegel; perfekt abgestimmte Crossfades; nahtlose Integration in eMotion LV1 Mixer sowie SuperRack; unterstützte Formate: Waves SuperRack, eMotion LV1 Mixer589,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
the t.bone Speech 100 Mthe t.bone Speech 100 M, Steuerzentrale für digitales Konferenzsystem, 2 Gruppen für jeweils bis zu 16 Sprechstellen, Feedbackunterdrückung, USB Aufnahme und Playback (*.mp3, Datenträger bis 32 GB), 4 Diskussionsmodi (3, 6, 9 oder alle Mikrofone können gleichzeitig aktiviert werden), Abstimmungs-Modus, 2x Stereo Rec Out (Cinch), 1x Stereo Out für Soundsystem (Cinch), 1x Stereo In (Cinch), 1x Mic In (XLR mit Phantomspeisung), 1x LAN, Abmessungen: 19" / 2HE, 32cm Einbautiefe, Gewicht 5,5 kg; passendes Case: Art. 496024 (nicht im Lieferumfang enthalten); passender Booster für mehr als 16 Sprechstellen je Linie: Art. 498125 (nicht im Lieferumfang enthalten)469,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was bedeutet Hate Speech?
Hate Speech bezeichnet beleidigende, diskriminierende oder gewalttätige Äußerungen, die aufgrund von Rasse, Religion, Geschlecht, sexueller Orientierung oder anderen persönlichen Merkmalen Hass und Feindseligkeit fördern. Es handelt sich um eine Form der verbalen Gewalt, die Menschen verletzen und ihre Rechte verletzen kann. Hate Speech ist in vielen Ländern gesetzlich verboten und wird von Online-Plattformen und sozialen Medien zunehmend bekämpft. **
-
Was ist Hate Speech?
Hate Speech bezieht sich auf Äußerungen, die Hass, Diskriminierung oder Gewalt gegen bestimmte Personen oder Gruppen aufgrund ihrer Rasse, Religion, sexuellen Orientierung, Geschlecht oder anderer Merkmale fördern oder unterstützen. Diese Äußerungen können sowohl online als auch offline stattfinden und haben das Potenzial, Schaden anzurichten und die Opfer zu verletzen. Hate Speech wird oft als Verstoß gegen die Meinungsfreiheit betrachtet, aber es gibt rechtliche Grenzen, die den Schutz vor Hass und Diskriminierung gewährleisten sollen. **
-
Wie klingt die deutsche Meme-Stimme in der Text-to-Speech-Technologie?
Die deutsche Meme-Stimme in der Text-to-Speech-Technologie kann je nach Anbieter und Einstellungen variieren. Generell wird sie jedoch oft als roboterhaft und künstlich klingend beschrieben, mit einer betonten und leicht übertriebenen Aussprache. Manche Stimmen haben auch einen humorvollen oder ironischen Unterton, um den memeartigen Charakter zu verstärken. **
-
Was sind die beliebtesten Acts in einem Zirkus?
Die beliebtesten Acts in einem Zirkus sind normalerweise Akrobaten, Clowns und Tierdressuren. Diese Acts bieten eine Mischung aus Spannung, Unterhaltung und Humor für das Publikum. Jeder Zirkus hat jedoch seine eigenen einzigartigen Acts, die die Besucher anlocken. **
Ähnliche Suchbegriffe für Speech-Acts-in-Securitization
-
the t.bone Speech 100 Cthe t.bone Speech 100 C, Chairman, Präsidentensprechstelle für digitales Konferenzsystem, Kondensatormikrofon, LCD-Display, Tasten für Abstimmung, eingebauter Lautsprecher mit Lautstärkeregelung, Kopfhöreranschluss, Prioritätssteuerung für Präsidentensprechstelle, 2x LAN (In/Link), Mikrofon-Schwanenhalslänge ca. 40 cm, 1x 2m Netzwerkkabel im Lieferumfang enthalten, Abmessungen: 169 x 46 x 175 mm (B x H x T), Gewicht 0,7 kg198,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
the t.bone Speech 100 Bthe t.bone Speech 100 B - Netzteilerweiterung (Booster) für die Sprechstellen 100 C und 100 D des digitalen Konferenzsystem Speech 100, ein 100 B versorgt bis zu 32 zusätzliche Sprechstellen (1x 100 M +1x 100 B = 2x16 + 2x16 =64); mit einem zweiten sind bis zu 72 Mikrofonstationen (max.) möglich (1x 100 M +1x 100 B +1x 100 B = 2x12 + 2x12 +2x12 =72); Leistungsaufnahme 72W; Abmessungen; 305x197x45mm; Gewicht: 2,45kg169,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
PIKO 59435 H0 Diesellok 6004, ACTS, Ep. VIEhemalige V 60 der Deutschen Reichsbahn im Einsatz des privaten niederländischen EVUs ACTS in attraktiver blauer Lackierung. Stromsystem: Gleichstrom Bahnverwaltung: Privatbahn Epoche: VI Maßbezeichnung: LüP / Länge über Puffer Maß [mm]: 125 Mindestradius [mm]: 358 Digitale Schnittstelle: NEM 652 Anzahl Haftreifen: 2 Kupplung: NEM Schacht + Kurzkupplungskulisse Sound: PIKO Sound-Modul nachrüstbar #56320 + #56403 Lichtwechsel: Fahrtrichtungsabhängiger Lichtwechsel weiß / rot159,46 €*Versand: 5,99 €Sichere Weiterleitung zum Anbieter
-
Wie funktioniert Speech to Text?
Speech to Text funktioniert, indem gesprochene Wörter mithilfe von Spracherkennungssoftware in Text umgewandelt werden. Dabei werden die Audiosignale des gesprochenen Textes analysiert und in Text umgewandelt. Die Software erkennt dabei Sprachmuster, Wörter und Sätze, um sie korrekt zu transkribieren. Dieser Prozess basiert auf komplexen Algorithmen und künstlicher Intelligenz, die kontinuierlich verbessert werden, um die Genauigkeit der Umwandlung zu erhöhen. Das Ergebnis ist ein geschriebener Text, der die gesprochene Sprache möglichst genau wiedergibt. **
-
Wie hat sich die Text-to-Speech-Technologie in den Bereichen der barrierefreien Kommunikation, der Unterhaltungsindustrie und der Bildung weiterentwickelt?
Die Text-to-Speech-Technologie hat sich in den Bereichen der barrierefreien Kommunikation weiterentwickelt, indem sie eine verbesserte Sprachqualität und natürlichere Betonung bietet, um Menschen mit Sehbehinderungen den Zugang zu gedruckten Materialien zu erleichtern. In der Unterhaltungsindustrie hat die Technologie dazu beigetragen, Hörbücher, Podcasts und Videospielen eine realistischere und immersivere Erfahrung zu bieten. Im Bildungsbereich ermöglicht die Text-to-Speech-Technologie eine individualisierte Lernumgebung, in der Schüler mit unterschiedlichen Lernstilen und Bedürfnissen unterstützt werden können. Darüber hinaus hat die Technologie die Möglichkeit eröffnet, Lehrmaterialien in verschiedenen Sprachen und Dialekten zugänglicher zu machen. **
-
Wie hat sich die Text-to-Speech-Technologie in den Bereichen der barrierefreien Kommunikation, der Unterhaltungsindustrie und der Bildung weiterentwickelt?
Die Text-to-Speech-Technologie hat sich in den Bereichen der barrierefreien Kommunikation weiterentwickelt, indem sie Menschen mit Sehbehinderungen ermöglicht, gedruckte Texte in gesprochene Sprache umzuwandeln. In der Unterhaltungsindustrie wird die Technologie verwendet, um Hörbücher, Podcasts und Videospielen eine zusätzliche Dimension hinzuzufügen. In der Bildung wird Text-to-Speech eingesetzt, um Schülern mit Lernschwierigkeiten oder Sprachbehinderungen zu helfen, Texte besser zu verstehen und zu verarbeiten. Durch ständige Verbesserungen in der Spracherkennung und -synthese wird die Text-to-Speech-Technologie immer präziser und natürlicher. **
-
Wann ist das Hate-Speech-Gesetz in Kraft getreten?
Das Hate-Speech-Gesetz in Deutschland, das offiziell als Netzwerkdurchsetzungsgesetz (NetzDG) bekannt ist, ist am 1. Oktober 2017 in Kraft getreten. Es verpflichtet soziale Netzwerke dazu, rechtswidrige Inhalte innerhalb einer bestimmten Frist zu löschen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.